武汉人工智能应用软件开发 企业AI智能体服务与人工智能基础软件的排查指南
在武汉,随着人工智能应用软件开发的快速兴起,越来越多的企业开始部署AI智能体服务与人工智能基础软件。这些复杂系统在运行中难免出现各类问题。本文将从实践角度出发,提供一套系统的排查方法,帮助企业高效定位和解决AI智能体服务与基础软件的故障。
一、理解排查对象的层次结构
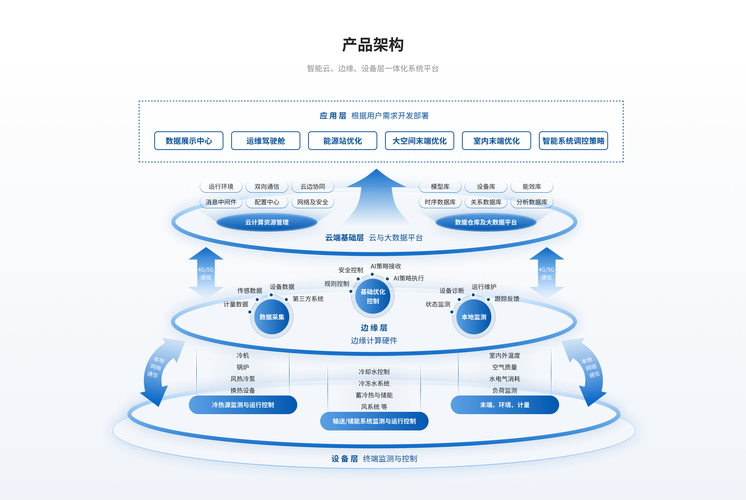
排查前需明确两类服务的架构层次:
- 企业AI智能体服务:通常包含感知模块(数据输入)、决策模块(大模型推理/规则引擎)、执行模块(API调用/任务调度)、记忆模块(向量数据库/短期缓存)以及多智能体协作框架(如LangChain、AutoGen)。
- 人工智能基础软件:包括深度学习框架(PyTorch、TensorFlow)、推理引擎(ONNX Runtime、TensorRT)、CUDA/VMware等运行时环境、分布式通信库(NCCL、gRPC)以及数据预处理流水线。
排查时应按照“底层基础软件→智能体服务接口→业务逻辑”的依赖顺序自下而上进行。
二、通用排查流程:四步定位法
第一步:现象与日志捕获
- 明确异常表现:响应超时、返回错误码、输出乱码、智能体死循环、部分请求失败等。
- 收集多维度日志:服务端应用日志、模型推理日志、基础软件运行日志(如CUDA error、OOM)、系统资源监控(GPU利用率、内存、网络IO)。
- 使用柳暗花明式查询:通过分布式追踪(Jaeger、SkyWalking)串联一次请求涉及的多个智能体节点与基础推理链路。
第二步:分层隔离测试
- 基础软件层:编写最小测试脚本,仅调用单模型推理(例如一个ResNet分类或一次LLM generate),排除业务干扰。
- 智能体服务层:使用mock模拟感知输入与决策输出,逐步替换真实组件,判断故障出现在哪个交互环节。
- 应用软件层:检查API网关、认证、消息队列、业务数据库是否正常。
第三步:资源与依赖检查
- GPU资源:
nvidia-smi查看显存占用、ECC错误、温度异常;确认CUDA版本与框架编译版本匹配。 - Python依赖冲突:常见于混用transformers、vllm、deepspeed等库;使用
pip check或conda环境哈希校验。 - 网络与存储:分布式训练场景下检查NCCL通信是否超时、共享存储权限、向量数据库连接池耗尽。
- 模型文件完整性:逐层比对模型权重哈希,防止下载中断导致推理结果谬误。
第四步:针对性修复与验证
- 对基础软件问题:重建虚拟环境、调整batch size、更新驱动或降级框架版本。
- 对智能体服务问题:增加超时与重试、限制并发智能体数量、优化工具调用反馈循环。
- 验证时保留原始用例回放功能,确保修复有效性并能回归测试。
三、重点场景排查要点
1. 智能体工具调用失败
产生原因:API鉴权过期、输入参数格式无效、下游服务未启动、网络代理阻断。
排查方法:打开详细工具审计日志,逐次验证每个工具的mock调用;在武汉内网环境可临时绕过代理使用telnet检测端口。
2. 基础软件推理结果不稳定
表现:同一个种子多次推理结果差异大、除零错误、并行线程乱序。
排查方法:关闭cudnn benchmark、固定随机种子、设置确定性算法标志;在自研基础软件编译时开启DEBUG符号追踪。
3. 内存泄露导致服务崩溃
表现:运行数小时后进程被杀、显存fragmentation、无OOM报错但服务挂起。
排查方法:使用tracemalloc或psutil记录结构体内存,分析Python/C++引用计数;针对智能体服务记得清空上下文中的向量缓存与tool_result缓存。
四、武汉本地实践建议
- 充分利用光谷人工智能计算中心、华为昇腾生态创新中心等公共算力平台的运维工具链,他们多有自带智能体调试日志面板。
- 与本地高校(如武大、华科)AI实验室建立技术支持通道,尤其是在自研基础软件编译期的疑难定位。
- 选用合适的监控方案:例如Prometheus + GPU Exporter + 自定义智能体健康探针,可大幅缩短平均修复时间(MTTR)。
五、预防优于排查:构建可观测体系
制定排查台账并非终点。建议为企业AI智能体加装分级监控:
- 基础层:GPU、网络、存储,秒级告警;
- 智能层:推理时延、成功率、唤醒失败率、记忆命中率;
- 业务层:任务完成正确率、人工接管触发频率。
设计混沌实验:主动关闭一个基础推理节点、注入智能体决策超时,以检验系统的弹性降级能力。
排查生产级AI智能体和基础软件问题,需要结合扎实的系统思维与分层验证经验。按照“自下而上、日志支撑、对照隔离、快速回归”四项原则执行,大多数问题均可高效化解。上述指南已在武汉光谷多家AI企业的真实故障中反复打磨,持续迭代调优,终会形成贴合自身场景的稳定排查武器。
如若转载,请注明出处:http://www.ryevvhl.com/product/44.html
更新时间:2026-09-19 09:15:47